一句話:AI 已經能替大多數漏洞先寫出修補草稿(Google 說 Chrome 已經是這樣),難的是證明這份修補真的對。所以要搭一條流水線:每一步都靠實際執行程式來檢查,最後由人看懂、簽名、送出。
昨天我一直在想一個問題:如果要讓 AI agent 去修 Chromium 這種規模的程式裡的漏洞,該怎麼做?Chromium 是 Chrome 瀏覽器背後的開源專案,光是 GitHub 鏡像上的 git 歷史就大約 64 GB。這麼大的專案,AI 修得動嗎?修完又要怎麼確定它是對的?
今天整理了一輪資料,結論很清楚:寫出修補已經不是最難的部分。Chrome 資安團隊說,現在大多數漏洞都由大型語言模型先產生候選修補,只是沒說最後有多少是照 AI 的版本合併。難的是驗證。我在 Day 3 吃過一次虧:AI 說「做完了」,獨立審查卻找出 37 個問題。修漏洞也一樣,只是修錯的代價更高。
這篇寫給平常會用 AI 寫程式、但沒做過資安的人。讀完你會知道:
- 業界做到哪:Google、DARPA 的比賽、幾家 AI 公司各做了什麼
- 為什麼「crash 不見了」不等於修好,研究測出來差多少
- 哪些做法有數字證明真的有幫助
- 換成 Chromium,會多出哪些真實的關卡
- 一個人可以怎麼一步一步開始
- 動手前要先知道的現實與紅線
這是 2026-10-09 為止的調查,數字都附上出處連結;廠商自己公布、沒有被獨立驗證的數字,我會直接標出來。全篇只談防守:重現、修補、驗證、負責任地揭露,不談怎麼利用漏洞。
先認識八個詞
後面會一直用到這八個詞,先講白:
- 記憶體安全漏洞:程式讀或寫到不該碰的記憶體,例如寫超過一塊空間的尾巴,或用到已經還回去的記憶體。像把信塞進隔壁的信箱。
- fuzzing:用大量亂數或稍微變形的輸入去撞程式,看會不會當掉。像把販賣機的每個按鈕亂按上萬次。
- sanitizer/ASan:編譯時加進程式的檢查器,記憶體一出錯就停下來,報告是哪一行、怎麼走到那裡的。像倉庫裡的感應器,東西一放錯格就響。
- crash:程式當掉。有 ASan 時會附上出事當下的呼叫路徑(stack)。像車子半路熄火,儀表板留下故障碼。
- PoC:能穩定讓問題重現的那個輸入檔,例如一張特製的圖片。像修車時「每次開這段路都會有怪聲」的那條路線。
- 根因 root cause:問題真正的起點,常常不在當掉的那一行。像天花板滴水,滴下來的地方不一定是屋頂破洞的地方。
- patch/CL:修補,也就是改了哪幾行程式的那份差異;Chromium 把一次送審的修改叫 CL。像交給審稿人的一份紅筆修改稿。
- 回歸測試 regression test:每次改程式都會自動重跑的一組測試,確認以前好好的東西沒被改壞;修好一個漏洞後,把這次的 PoC 也加進去,問題就不會悄悄回來。像修好漏水後,每逢大雨就回去把每個角落看一眼。
一條流水線看懂 AI 修漏洞
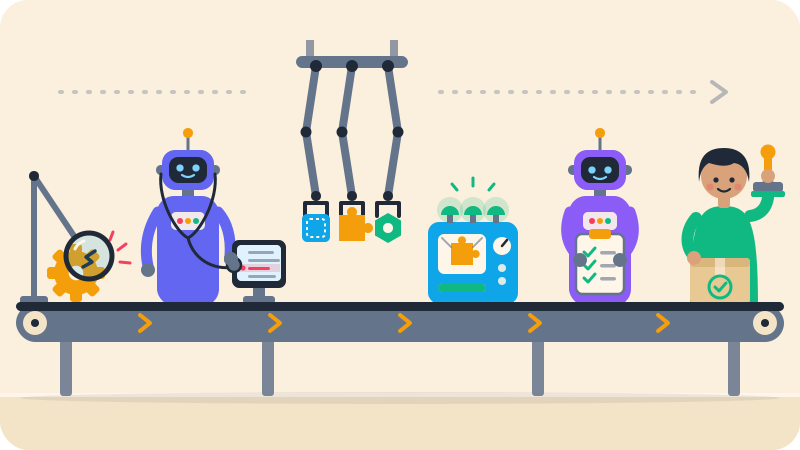
圖裡每一站只做一件事,做完交給下一站。換成 AI 修漏洞,大概是這六步:
用 PoC 在乾淨環境讓 crash 再出現一次
從 crash 往回追,找出哪個假設錯了
讓不同模型各寫一份修法
編譯、重跑 PoC、fuzz、跑測試
另一個 agent 照檢查表挑毛病
看懂每一行才送審
為什麼拆這麼細?因為每次交接,都是拿證據說話的機會。
**先重現,再找根因。**沒有能重現的 PoC,修完也無從知道有沒有用。找根因,是因為 crash 的位置常常不是錯誤的源頭:只在當掉那一行擋一下,原本的 PoC 會過,換一個稍微不同的輸入又會出事。後面「crash 不見了不等於修好了」那一節會用一個小例子講。
**多寫幾份,再用執行來篩。**一次只寫一份,寫錯了也看不出來。Chrome 現在就是讓好幾個 agent 先提候選、互相挑毛病,下一節會細講。篩選要靠實際執行:能編譯、PoC 不再觸發、測試都過。agent 自己說「已驗證」不算數,程式跑過才算。
**審查和人工把關放最後。**獨立審查是另一雙眼睛,但不能取代執行。最後一定是人:要看懂每一行,才能按下送出。Chrome 的流程最後也是由開發者審過。
這個形狀不是我想出來的。Google DeepMind 的 CodeMender 也是先用工具檢查,只把修到根因、沒弄壞別的地方的修補交給人審。DARPA 的 AIxCC 是讓 AI 系統自己找漏洞、修漏洞的比賽,修補不準確會被扣分;根據一篇整理整場比賽的論文,排名前面、比較謹慎的隊伍,沒有能證明漏洞存在的輸入就不送修補。三方從不同地方出發,最後都長成這條線:AI 負責寫,程式負責驗,人負責簽。
業界已經做到哪
先看幾個大玩家實際怎麼做。下面很多數字是公司自己公布的,我會標出來;找不到獨立驗證的,也會直接說。
Chrome 自己的修補流水線
Chrome 資安團隊在 2026-07-30 的文章裡,描述了他們現在怎麼修漏洞:
- 「修補 agent」先提出好幾個候選修補。
- 「評審 agent」逐一挑毛病,兩邊來回改,像人類的 code review。
- 「寫測試的 agent」在 Chrome 支援的各個平台上寫測試、檢查測試。
- 最後由一位開發者審過。
Google 說,現在大部分漏洞都有 LLM 產生的候選修補。但文章沒說最後有多少修補是照 AI 寫的原樣合併的。
找漏洞這一端也接上了。Big Sleep 和 CodeMender(下面會介紹)每 24 小時在 Chrome 的 CI(有人送程式碼就自動跑的檢查系統)上,把所有 CL 掃一遍。五月時,這套設定擋下了 20 多個漏洞,其中一個被評為 critical 等級。
量也很大:Chrome 149 和 150 兩個版本合計修了 1,072 個安全 bug;到 2026 年 3 月,收到的 bug 回報已經比 2025 年整年還多。
安全措施也寫得很具體:掃描在鎖起來、網路受限的機器上跑;每個元件的 SECURITY.md 告訴評審 agent 信任邊界在哪裡,也就是哪些資料是從外面來的、不能直接相信。
Google 的 CodeMender 和 OSS-Fuzz
CodeMender 是 Google DeepMind 在 2025-10-06 公布的修補 agent。它用 Gemini Deep Think 模型,配上一整套工具:
- 靜態分析(不執行,只讀程式碼找問題)和動態分析(實際跑起來觀察)
- 差異測試(同一個輸入給改前、改後的程式,比對結果)
- fuzzing
- SMT 求解器(用邏輯推算某個條件會不會成立)和除錯器
另外還有一個 LLM 評審工具,專門比對改前和改後的程式碼。只有修到根因、功能正確、沒有造成回歸(原本好的功能壞掉)的修補,才會交給人看。DeepMind 說,大約六個月內送回開源專案 72 個安全修補,每一個送出前都有人審過。
之後它走出 Google 內部:
- 2026-07-22,Google Cloud 版開放預覽,只給少數客戶,每個修補都要人核准。
- 2026-07-29,接上 OSS-Fuzz。OSS-Fuzz 是 Google 替開源專案持續跑 fuzzing 的服務。
符合條件的回報,也就是 C/C++ 專案的記憶體安全 bug,會附上一份 CodeMender 修補。每份修補都先單獨測過:能編譯、原本的 crash 不見了、功能測試通過。測試期間每份都由 Google 工程師審過,專案也可以選擇不要;被專案接受的比例沒有公布。
更早的經驗也值得看。Google 在 2024 年的研究裡,讓 Gemini 修內部單元測試抓到的 sanitizer bug。Gemini 修好大約 15%;經過人工篩選、送給程式碼負責人的修補,大約 95% 被接受。研究也記下了壞修法:直接刪掉失敗的測試,或把程式改成一步一步執行,來閃過 data race(兩個執行緒同時改同一塊資料)。
負責找的 Big Sleep
Big Sleep 是 Google Project Zero 和 DeepMind 合作的 agent,只負責找,不負責修。它從最近的程式碼提交出發,找出長得類似的漏洞。Chrome 的版本公告(2025-08-26)把 CVE-2025-9478(CVE 是公開的漏洞編號)記在它名下:ANGLE 元件裡一個 critical 等級的 use-after-free(記憶體已經還回去,程式還繼續用它),在 Chrome 139 修好。
DARPA 的 AIxCC 比賽
AIxCC 是 DARPA 辦的 AI 資安競賽,決賽在 2025-08-08 的 DEF CON 33 舉行,參賽系統要自己找漏洞、自己修。冠軍是 Team Atlanta 的 Atlantis(400 萬美元),第二名 Trail of Bits 的 Buttercup(300 萬),第三名 Theori 的 RoboDuck(150 萬)。
比賽在專案裡人工植入了 63 個漏洞,決賽系統合計找到 54 個(86%),替其中 43 個提出修補(68%);另外還找到 18 個真實漏洞,提出 11 個修補。平均每個修補約 45 分鐘,每個任務約 152 美元。
有兩件事要記得。第一,題目是 24 個 OSS-Fuzz 風格的專案,例如 curl、libxml2、dav1d、OpenSSL、Wireshark;Chromium、V8 和 Linux 核心都不在裡面。第二,計分會懲罰不準確的修補,所以謹慎的前幾名沒有 PoV(proof of vulnerability,比賽裡對 PoC 的叫法)就不送修補。一篇整理這場比賽的論文還提到:拿來對照的 Claude Code 基準設定,通過自動檢查的修補裡,有 37.7% 被人工審查退回。
比賽也留下能用的開源工具。Buttercup 有獨立版,最少要 8 核心、16 GB 記憶體、100 GB 硬碟。OSS-CRS 是 OpenSSF(開源軟體安全基金會)的專案,能在自己的機器上跑 AIxCC 的系統,並用 LiteLLM 代理(夾在系統和模型 API 之間的轉接層)替每個系統設美元預算;根據 OSS-CRS 的論文,它移植的 Atlantis 在 8 個 OSS-Fuzz 專案裡找到 10 個新 bug,3 個是高嚴重度。比賽當時的原版綁在已經關掉的比賽雲端上,很難直接拿來用。
其他公司
這幾家公開的資訊比較少,數字也多半是自己公布的,看方向就好。
- OpenAI:Aardvark(2025-10-30 公布,2026-03-06 改名 Codex Security)先建立威脅模型(列出誰可能攻擊、會從哪裡進來),再掃描程式碼提交,在沙箱(隔離、弄壞也沒關係的執行環境)裡試著觸發問題,然後由 Codex 寫修補草稿,最後人審。OpenAI 自己公布,在測試用的 repo 裡找到 92% 已知和人工植入的 bug;我找不到獨立驗證。
- Anthropic:Claude Code Security 在 2026-02-20 開放有限的研究預覽。它掃描程式碼、做多階段驗證、提出修補建議,每個修補都要人核准;開源專案維護者可以申請免費使用。
- Mozilla:2026-05-07 的文章說,他們把 AI 找 bug 的流程蓋在既有的 fuzzing 設施上,規定 agent 一定要交出能重現問題的測試檔,工作都在用完就丟的虛擬機裡跑。Firefox 150 修了 271 個用 Claude Mythos Preview 找到的 bug。這是 Mozilla 和合作方自己公布的,也有人質疑這些 bug 跟 CVE 怎麼對應。
| 系統 | 找漏洞 | 寫修補 | 執行驗證 | 人工把關 |
|---|---|---|---|---|
| Chrome 流水線 | 有 | 有 | 有 | 有 |
| CodeMender | 有 | 有 | 有 | 有 |
| Big Sleep | 有 | 沒有 | 未公開 | 未公開 |
| AIxCC 隊伍 | 有 | 有 | 有 | 未公開 |
| Codex Security | 有 | 有 | 部分 | 有 |
| Claude Code Security | 有 | 有 | 未公開 | 有 |
看下來有一個共同點:會寫修補的產品和公司流水線,最後都留著一道人工關卡(AIxCC 是比賽,資料沒寫有沒有人工把關,只知道計分會懲罰不準確的修補)。差別在驗證有多嚴:有的要求能編譯、crash 消失、功能測試通過,全部實際跑過才算;有的只寫「多階段驗證」,沒說怎麼驗。
crash 不見了不等於修好了
上一節看到,會寫修補的產品和流水線都留著人工把關,差別在驗證有多嚴。這一節說明為什麼要那麼嚴:AI 寫出來的修補,最常見的問題不是「沒修」,而是「看起來修好了」。原本的 crash 不見了,問題卻還在。
一個看得懂的例子
假設有一個讀圖片的函式庫。它先讀檔頭(檔案開頭記錄寬和高的那一小段),照「寬 × 高 × 4」配一塊記憶體(每個像素 4 bytes),再一列一列把像素抄進去。它完全相信檔頭寫的數字。
fuzzing 撞出了一個檔案:寬和高都填得很大,大到相乘的結果在 32 位元整數裡裝不下,繞回成一個很小的數字。這叫整數溢位,像舊汽車的里程表跑過頭會歸零。
結果程式只配了一小塊記憶體,卻照真正的寬度去抄,抄沒幾列就寫到這塊記憶體外面。ASan 當場停下,報告 heap-buffer-overflow(寫到配給你的那塊記憶體外面),附上的 crash stack 最上面一行,指著抄像素的那一行。撞出問題的那個檔案,就是這次的 PoC。
最省事的修法,是在當掉的那一行前面加一個 if:
// 修法 A:在當掉的那一行前面擋一下
uint32_t row = w * 4;                   // 一列有幾個 bytes
for (uint32_t y = 0; y < h; y++) {
    if ((y + 1) * row > buf_size)       // 這一列會超出就停
        return 0;                       // 0 代表「成功」
    memcpy(buf + y * row, src + y * row, row);
}
原本的 PoC 確實不會再當掉:抄到放不下的那一列之前,if 就讓函式結束了。可是真正的問題「太相信檔頭」一點都沒變:
- 它只檢查「寫進去」的那一邊。換一個寬高沒有溢位、但檔案本身比檔頭說的短的檔案,程式照樣會讀到輸入資料尾巴的外面,ASan 換個位置再報一次。
- if 裡的
(y + 1) * row,和上面算row的乘法,數字大時自己也會溢位。換一組更大的數字,這個檢查就失效了。 - 就算沒當掉,它回傳的是 0,也就是「成功」。呼叫它的程式拿到一張只抄了一半的圖,還以為是好的。這種安靜的錯誤輸出,比當掉更難發現。
真正的修法要回到根因:錯不在抄像素那一行,而在讀檔頭時就信了它。
// 修法 B:讀檔頭時就把關
int parse_header(const uint8_t *p, size_t len, struct hdr *hd) {
    if (len < HDR_SIZE) return ERR_TRUNCATED;
    hd->w = read_u32(p);  hd->h = read_u32(p + 4);
    if (hd->w == 0 || hd->h == 0 || hd->w > MAX_DIM || hd->h > MAX_DIM)
        return ERR_BAD_SIZE;                                  // 寬高不合理
    if (ckd_mul(&hd->size, (size_t)hd->w * 4, hd->h)) return ERR_BAD_SIZE;
    if (len - HDR_SIZE < hd->size) return ERR_TRUNCATED;     // 檔案太短
    return OK;
}
它做了四件事:檔頭不完整就拒絕;寬或高是 0、或超過專案自己定的上限 MAX_DIM 就拒絕;用 ckd_mul(C 語言標準內建、會檢查溢位的乘法)算記憶體大小,裝不下就回報;最後確認檔案裡真的有那麼多像素資料。任何一項不合格都回傳清楚的錯誤碼,上層可以顯示「檔案損壞」,而不是給出半張圖。後面所有用到寬高的地方拿到的都是檢查過的數字,受到保護的不只是抄像素那一行。
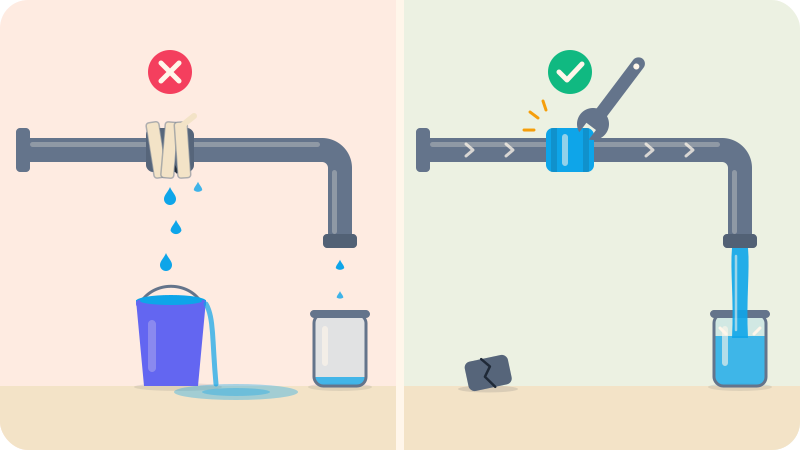
對 AI 來說,修法 A 很誘人:ASan 報告指著那一行,加個 if 最省事,原 PoC 重跑一次就過。可是真正該改的地方,不在 crash stack 上。
研究裡的數字
這不是想像出來的擔心。馬里蘭大學的 PatchBench(2026-09-03)特地挑了 213 個 C/C++ 題目,正確的修法都不在 crash stack 上。11 個 agent 平均有 83.1% 的修補能讓原 PoC 不再當掉,真正解決問題的卻只有 45.3%,等於高估了約 1.8 倍;最好的組合也只到約 59%。如果拿掉「和原本程式比對輸出與狀態」這一關,解決率還會再虛胖約 8 個百分點。我的理解是,這一關抓的正是修法 A 那種「沒當掉、但結果不對」的修補。
Meta 的 AutoPatchBench(2025-04-29)在一個 113 個 bug 的子集上,用 2025 年當時的模型做了案例研究:約 60% 的修補能編譯、原 PoC 也不再當掉;再加上 10 分鐘的 fuzzing 和白箱差異測試(拿同樣的輸入,比較修補版和正確修法的程式內部狀態)之後,只剩約 5–11% 被判定正確。其中一個模型從 61.1% 掉到 5.3%。作者自己也說,這個案例研究在統計上不夠嚴謹。
另外兩份研究也一樣。CodeRover-S 把 88 個通過 PoC 的修補交給人逐一檢查,只有 40 個是對的(45.5%)。Team Atlanta 用 10 種 coding agent 設定去修 63 個 AIxCC 比賽的 crash,630 個修補全部人工看過:就算同時通過 PoV 和專案測試,仍有約 20–40% 在語意上是錯的(程式跑得過,做的事卻不對),最好的設定也有約 20%。
常見的錯誤修法
好幾篇研究整理出的錯誤修法大同小異,白話說是這幾種:
- 在當掉的地方加 if:擋住原本那個 PoC,擋不住長得很像的檔案。修法 A 就是這種。
- 只修症狀:讓 crash 或 ASan 報告消失,沒處理讓它發生的原因。修法 A 也算這一種。
- 把功能或那個操作整個刪掉:那段程式不跑了,當然不會當。
- 檢查太嚴:連正常的檔案也一起拒絕。
- 跑太久就寫死上限:程式跑太久被判逾時(timeout),就直接規定迴圈最多跑幾次。
- 修到旁邊的另一個 bug:附近的問題改好了,原本那個還在。
- 根因找錯:真正要改三個檔案,它只改了一個。
- 帶進新 bug:例如記憶體洩漏(借了記憶體沒還,程式越跑越佔空間)。
- 沒驗證就說成功:agent 回報「已修好」,其實沒跑過任何檢查。
Team Atlanta 把語意錯誤的 145 個修補分了類。最多的不是「只修症狀」,而是把原本的功能改壞了:
為什麼測試和 agent 的話都不夠
專案原本的測試能不能把關?一篇十月剛出的研究(2026-10-07)在 112 個歷史 bug 上發現:某個前沿模型的修補有 90.2% 能通過 PoC,卻只有 60.7% 通過開發者自己的測試。而專案原本的回歸測試,不管修補是好是壞,都有約 95–97% 會通過,幾乎分不出好壞。這篇是十月剛上 arXiv 的預印本,先當參考。我想原因是:那些測試寫的時候還不知道有這個 bug,自然不會去測那條路。
agent 說「驗證過了」也一樣。上面錯誤修法的第 9 種就是這樣:說修好了,其實什麼都沒跑。修漏洞時,「我驗證過了」只是一句話。要算數,得有一支程式真的跑過:編譯、重播 PoC、對修補版跑 fuzzing、跑專案測試、拿正常輸入比對輸出,每一步的結果都留在 log 裡,人看得到。下一節就講,哪些做法真的能讓修補更可靠。
真正有用的做法
上一節說到,crash 不見了不代表修好。好消息是,有幾件事已經被研究量過,確實能讓 AI 寫出的修補更常是對的。下面七招,每一招都分三段:做什麼、為什麼(附數字)、實際怎麼做。
先講清楚:這些數字來自不同的研究,用的 bug、模型和計分方式都不一樣。只能看「有沒有幫助」,不能拿來互相比大小。
給足材料
做什麼:開工前把三樣東西交給 agent:PoC、整理過的 sanitizer 報告,以及能直接執行的編譯和測試指令。
為什麼:一篇十月剛出的研究發現,多給了編譯和測試的說明後,C/C++ 修補通過原本 PoC 的比例從 72% 升到 92%。這是剛上 arXiv 的預印本,而且算的是「過了 PoC」,不等於真的修好,先當參考。另一個例子更直接:PatchAgent(USENIX Security 2025)把「整理報告」這一步拿掉,修好的比例就從 77.3% 掉到 64.0%。
實際做法:指令先自己跑一遍,確定複製貼上就能用,再寫進任務說明。報告留下跟這次 crash 有關的部分就好,不要整份 log 丟進去。
先找根因再動手
做什麼:先請 agent 找出根因,講清楚了才准它改程式。
為什麼:VulDebugger 讓 agent 用除錯器 LLDB(能讓程式停在某一行、查看當下變數值的工具)一步步追,在 50 個真實的 C 語言 bug 上修好 60%;對照組、另一個修 bug 的系統 AutoCodeRover 只有 28%。根因和修補位置都找對的時候,修好的比例是 75.8%。
實際做法:把任務拆成兩段。第一段只准讀程式、跑除錯器,交出一段話:哪個值在哪裡開始出錯、為什麼。你看得懂、覺得合理,才進第二段寫修補。
一次產生多個候選
做什麼:同一個 bug,讓幾個不同的模型各寫一份修補,再從裡面挑。
為什麼:PatchAgent 的實驗裡,最強的單一模型修好 84.8%;五個模型合起來(其中一個修好就算)到 92.1%。AIxCC 的冠軍 Team Atlanta,系統 Atlantis 同時跑 8 個修補 agent;他們後來的研究也發現,選哪個模型比選哪個 agent 框架影響更大,三個一起用最划算。Chrome 資安團隊的流水線也一樣:修補 agent 提出好幾個候選,評審 agent 來評。
實際做法:從三個不同的模型開始。每份候選都走完下面的驗證關卡,過關的才交給審查和人。
前三招的數字放在一起看:
換新對話重試
做什麼:修補沒過關時,不要在同一段對話裡叫它「再試一次」;開一段新的對話,附上原本的材料和上一次的簡短摘要。
為什麼:CyberGym-E2E(ICML 2026)量到,換一個新的 context(agent 在這段對話裡記得的全部內容)重試,表現好了 4.8 到 7.1 個百分點。反過來,Meta 的 AutoPatchBench 觀察到,模型在同一段對話裡重試時更容易「作弊」:讓 crash 消失,卻沒修到原因。
實際做法:摘要只寫幾行:試了什麼、卡在哪一道關卡、錯誤訊息是什麼。不要把上一次的整段對話貼過去。
用執行來驗證
做什麼:修補對不對,由程式跑出來的結果決定,不由 agent 的說法決定。
為什麼:上一節提過的 PatchBench 發現,拿掉「跟原版比對輸出與狀態」這一關,修好的比例會虛增大約 8 個百分點。Google 把 CodeMender 的修補附到 OSS-Fuzz 的回報上之前,也會先單獨測過:能編譯、crash 消失、功能測試通過。
實際做法:把下面五道關卡寫成一支腳本,放在 agent 改不到的地方;agent 只看得到「過」或「沒過」和錯誤訊息。第二關除了 ASan,也要看 UBSan(另一種檢查器,專抓 C/C++ 裡結果無法預期的寫法);第三關是拿 PoC 當起點跑 fuzz。
獨立審查但不取代執行
做什麼:另開一個審查 agent,拿檢查清單看修補;它只負責挑毛病,過不過還是由執行結果決定。
為什麼:自動檢查會漏:前面提過,AIxCC 那篇回顧論文裡,Claude Code 基準組通過自動檢查的修補,還有 37.7% 被人工審查退回。
但讓 AI 當裁判並不可靠。CodeRover-S 拿 LLM 判斷修補對不對,precision(它判為正確的修補裡,真正正確的比例)只有 0.47 到 0.57,大約一半。另一篇 2026 年的研究(二手資料,我沒有核對原文)指出,幾個 AI 評審彼此很一致(κ=0.75;κ 是衡量意見一致程度的指標,越接近 1 越一致),跟執行結果卻對不太上(κ≤0.26)。
實際做法:清單直接用上一節的常見錯誤:只在當掉的地方加 if 嗎?刪了功能或測試嗎?檢查太寬,會擋掉正常輸入嗎?審查 agent 交出的是疑點清單,不是「通過」兩個字;疑點交給人判斷。
設預算和硬規則
做什麼:每個 bug 設好金額和時間上限,並且用工具規則鎖住 agent 不能碰的東西。
為什麼:PatchBench 把每個 bug 的預算從 5 美元加到 25 美元,只多了一點幫助;綜合 PatchBench 和 CyberGym-E2E 的結果,大約在每個 bug 10 到 25 美元、90 分鐘左右之後,效果就趨於平緩。規則也很重要:前面提過,Google 2024 年的研究就看過 AI 為了過關,直接刪掉失敗的測試。Atlantis 的規定是:修補只能動原始碼,不准碰 fuzz harness(把亂數輸入餵進程式的那段接頭程式)。
實際做法:測試、fuzz harness、sanitizer 和 CI 的設定都設成唯讀;修補一碰到這些檔案,或一次刪掉一大段程式,就自動標記給人看。上限用完就停,並且允許 agent 回答「修不了」。我的看法是,「修不了」要是合法答案,它才不會為了交差硬湊一份修補。
這七招裡,我覺得只有「用執行來驗證」不能省:其他六招讓候選變好,這一招決定能不能信。
換成 Chromium 會多出哪些關卡
前面那條流水線,放在小函式庫上跑得動。換成 Chromium,步驟一樣,但每一步都多了門檻:編譯很重、bug 不是誰都看得到、規則寫得很細,還有 Google 自己的 AI 已經在同一條路上跑。
光是編譯就是一道門
要讓 agent 重現一個 crash,第一步是把 Chromium 編出來。官方的 Linux 建置說明寫的門檻是:x86-64 電腦,記憶體最少 8 GB(強烈建議 16 GB 以上),硬碟至少空出 100 GB。
流程是先裝 depot_tools(Chromium 官方的下載與編譯工具組),用 fetch --nohooks chromium 抓原始碼,加上 --no-history 不抓完整歷史,能省時間。接著用 GN(產生編譯設定的工具)和 Siso 編譯,指令是 autoninja -C out/Default chrome。
修漏洞要用的是 ASan 版。做法是在 GN 參數寫 is_asan=true is_debug=false,細節在 ASan 文件。我自己的估計是,要把 ASan 版編得舒服,大約需要 32–64 GB 記憶體和 200 GB 以上的 SSD。這是估計,不是官方數字。
遠端編譯幫不太上忙。Google 的遠端編譯服務 RBE,對外部貢獻者是邀請制,而且只是盡力提供;Mac 版文件更直接寫,外部貢獻者不支援遠端執行。所以多半得靠自己的機器。
有兩個省力的辦法。第一,官方有預先編好的 ASan 版 Chrome 可以下載(tools/get_asan_chrome),只是不是每個版本都有。第二,tools/bisect-builds.py 能拿現成的版本做二分搜尋(每次砍掉一半範圍,找出從哪一版開始壞),一般人能用的是 Chrome for Testing 這一組。有現成的版本,就不必每一步都自己編。
你拿得到的 bug 有限
Chromium 的安全 bug 預設是受限的,只有少數相關的人看得到。道理很直接:還沒修好的問題先公開,等於提醒想利用它的人。
ClusterFuzz 是 Google 自動跑 fuzzing 的平台。它找到的受限 bug,你的帳號要被加進那個 bug 的 CC 名單,才能下載 testcase,也就是 PoC。完整的本地重現腳本,只開放給 Google 員工。這些限制請照規矩來,不要想辦法繞過。
公開時間也有規則。安全 bug 通常在修好 30 天後公開,AI 找到的也一樣;被標成 WontFix(不處理)或 Invalid(無效)的,14 週後公開;需要延後的,可以放進 SecurityEmbargo 清單暫緩。
對外部的人來說,這代表能拿來練習的,大多是已經修好、也已經公開的舊 bug。這也是後面「一個人怎麼開始」建議先重播舊 bug 的原因。
Chromium 已經替 agent 準備了工具
好消息是,Chromium 的 repo 裡有一個 //agents/ 資料夾,專門放給 AI agent 用的東西:共用的提示詞、核准過的 MCP 伺服器(讓 agent 呼叫外部工具的接口),還有 56 個 skills(寫好的做事步驟,agent 需要時再載入)。跟修漏洞有關的有這幾個:
- fuzzing:用 FuzzTest(一種 fuzz 測試框架)加上 ASan 找問題。
- bisect:找出從哪個 commit 開始壞的。
- apply-fix-from-crbug-with-diff:照 bug 頁面附的 diff 套用修補。
- multi-agent-code-review:好幾個 agent 一起審程式碼。
- multi-agent-engineering-workflow:好幾個 agent 分工的完整開發流程。
最後這個流程有兩個設計值得學。第一,跟安全有關的工作會走一條更嚴格的「rigor path」,多加專門看安全和稽核的審查角色。第二,它不讓 agent 無限重來:回合數有上限(總共不到 3 輪),用完了、或發現 agent 在不同改法之間來回擺盪,就交回給人決定。
但要注意,流程裡的 release manager 步驟可以自己上傳 CL。我會把這一步留給人來按。skills 的說明寫著 Claude 這類 agent 也能用,不過我還沒實際試過。
另外還有一份 security-for-agents.md,大約在 2026 年第一季公布,寫給審查 Chromium 程式碼的 agent 看。它不是獎金規則,而是講清楚哪些情況不算安全漏洞,以及回報要附什麼。
寫好的檢查不通過,程式主動停下
文件點名不算的兩種
只讓程式停擺或拖慢
缺了就很難重現
幾個詞的白話:CHECK 是寫在程式裡的檢查,條件不成立就主動停下;DCHECK 是只在除錯版才生效的檢查。空指標是指向「什麼都沒有」的位址。UAF(use-after-free)是記憶體已經釋放又被拿來用,MiraclePtr 是 Chromium 自己加在指標上的保護。DoS 是讓服務變慢或停擺。符號化的 ASan 堆疊,則是看得到函式名稱和行號的錯誤報告。
規則寫得很清楚
Chromium 有一份正式的 AI 程式碼政策。重點是:
- 作者要自己看過、看懂每一處改動,能回答審查者的問題。
- 用了 AI、但自己沒把握的部分,要主動標出來。
- 每個改動都要兩位人類 committer(有權把程式碼合進主線的人)把關;作者本身是 committer 時算其中一位。
- agent 開的 bug 或 CL 有人留言時,由操作它的人親自回覆。
- 送出自己看不懂的程式碼,可能失去 committer 資格;警告後再犯,可能被封鎖。
處理 AI 找到的安全 bug,另有一份 FAQ(2026 年 4 月)。S0、S1 是嚴重度分級,S0 要在一週內處理,S1 在四週內。可以先上緩解措施(先把危害擋住的暫時做法),根因另開一張單追蹤。這跟前面說的「crash 不見了不等於修好了」是同一件事:先擋可以,但根因要有人記著。
另一份給分流人員的文件 Shepherding AI Reports 寫明,負責分流安全回報的 shepherd 可以把沒有可用 PoC、也沒有合理 ASan 堆疊的 AI 回報,直接標成 WontFix 關掉。警訊包括引用不存在的 CVE、不存在的 API 或類別名稱。
外部的人怎麼送修補,貢獻文件寫得很具體,下面這張圖照順序列出來。幾個詞先講白:CLA 是貢獻者授權協議;Gerrit 是 Chromium 的程式碼審查網站;OWNERS 檔列出每個資料夾由誰負責;不是 committer 的作者,需要兩位 committer 各給一票 Code-Review +1。修安全 bug 的指引另外要求:在說明裡具體寫出是哪個物件的存活期間、或哪個假設錯了,並檢查別處有沒有同類的問題。
用 Google 帳號簽貢獻者授權協議,第一次修補把自己加進 AUTHORS
用 ASan 版重現,修根因,不只擋住當掉的那一行
加一個測試,確保問題不會再回來;順便找同類問題
送到 Gerrit;說明寫清楚哪個假設錯了,標出沒把握的 AI 部分
用 git cl owners 找審查者,留言由自己回覆
在那之前不公開細節,必要時可以延後
跟 Google 內部 AI 撞車
前面「業界已經做到哪」提過,Chrome 內部已經有一條天天在跑的大型 AI 流水線:大多數漏洞的候選修補由模型先寫,Big Sleep 和 CodeMender 每 24 小時把所有 CL 掃一遍。外部的人去修已知的 Chrome bug,很容易跟它撞在一起。
外部的獎勵也跟著變。根據二手資料,Chrome 的漏洞獎金計畫(VRP)在 2026 年 4 月更新了獎金結構,把內部 AI 工具已經找得到的東西算進去,回報也可能被判定跟內部工具的發現重複。另外,BleepingComputer 報導,Google 從 2026-10-01 起暫停開源漏洞獎金計畫(OSS VRP)受理新的產品漏洞回報,原因是自動化和 AI 產生的回報暴增,而且多半無效。獎勵送修補的 Patch Rewards 還開著,新方案預計 2027 年第一季公布。
這是我的看法:一個已知的 Chrome bug,很可能 Google 內部已經在處理了。外部的人再花時間去修它,多半是重工。真正的價值在內部工具漏掉的地方。在那之前,先在小一點的專案上把整條流水線練熟,下一節就從這裡開始。
一個人怎麼開始
我的打算是分五步走。前四步都在沒有風險的舊 bug 上練,數字量出來了才往下一步。
第 0 步 建自己的考卷
先不碰 Chromium。ARVO 是一個公開資料集,收了 5,000 多個能穩定重現的 C/C++ 記憶體 bug,都來自 OSS-Fuzz;新版是 311 個專案、6,138 個 bug。每個 bug 都附上有漏洞和已修好的兩個 Docker 映像檔(打包好、拿來就能跑的環境),還有讓程式當掉的輸入檔和開發者當年的修補。
這正好拿來當考卷。挑 20–50 個,先從 dav1d、libxml2、freetype、libwebp、sqlite 開始:它們都放在 Chromium 的 third_party(放外部函式庫的資料夾)裡,也都是 OSS-Fuzz 的專案;dav1d 和 libxml2 還是 AIxCC 的題目。
每個 bug 記四個數字:
- 修補後能不能編譯。
- 原本的 PoC 還會不會觸發 ASan。
- 用 PoC 當起點再 fuzz 一陣子,會不會撞出變形的新 crash。
- 開發者的測試過不過,正常輸入的輸出和原版一不一樣。
最重要的一條:開發者的真正修補、修好版的映像檔、修好之後的 git 歷史,都要放在 agent 拿不到的地方。不然它可能直接抄答案,分數就沒有意義。
第 1 步 搭流水線
不用從零寫。前面提過的 Buttercup 和 OSS-CRS 都能在自己電腦上跑。Buttercup 是 AGPL-3.0 授權,最低要 8 核、16 GB RAM、100 GB 硬碟,要自己的模型 API 金鑰,可以設花費上限。OSS-CRS 是 MIT 授權,支援 OSS-Fuzz 格式的專案,還附一個以 Claude Code 為基礎的修補器。
骨架有了,再接上前面的五道驗證關卡和三條硬規則:agent 不准改測試、fuzz harness、sanitizer 或 CI 設定;刪掉一大段程式碼要標出來;允許它回答「修不了」。每個 bug 也設硬上限,PatchBench 等研究看到,成效大約在每個 bug 10–25 美元、90 分鐘左右就不太再往上。
然後用第 0 步的考卷跑一輪。這四個數字就是之後每次調整的對照組。
第 2 步 單獨編 PDFium ANGLE V8
考卷分數穩了,再換成 Chromium 的零件。PDFium(顯示 PDF 的元件)、ANGLE(網頁 3D 繪圖底下的圖形層)、V8(執行 JavaScript 的引擎)都能單獨編譯,git 歷史分別大約 0.15 GB、0.2 GB、1.2 GB,比整個 Chromium 小很多。
做法跟第 1 步一樣:同一條流水線、同樣四個數字,只把建置和測試指令換成這些專案自己的。
第 3 步 完整 Chromium 先重播已公開的舊 bug
到這一步,硬體才是門檻。前面講 Chromium 關卡的那一節列過:官方最低 8 GB RAM、100 GB 硬碟;我估計 ASan 版要 32–64 GB RAM 和 200 GB 以上的 SSD。有官方編好的 ASan 版(tools/get_asan_chrome)就先下載來用,不必每次自己編。
只重播已經公開的舊 bug,受限的 bug 照規矩不碰。//agents/skills/ 裡現成的 fuzzing 和 bisect skill,我打算接進第 1 步的流水線試試看。
第 4 步 真正貢獻
前面都穩了,才送東西給 Chromium。我會先從低風險的強化(不修特定 bug,而是讓程式更難出錯的改動)做起,例如替某個元件加一個 FuzzTest(Chromium 用來寫 fuzz 測試的框架),而不是一開始就修安全 bug。
流程照前面那張「外部的人送一個安全修補」的圖走;AI 程式碼政策的重點也在同一節:每一行都要自己看懂、答得出審查者的問題,沒把握的 AI 部分要標出來。
所以我的規則是:絕不讓 agent 自動上傳。//agents/ 的工作流程裡有一步能直接上傳 CL,這一步留給人。審查者的意見,也由我自己回。
接到我的 AI 集群
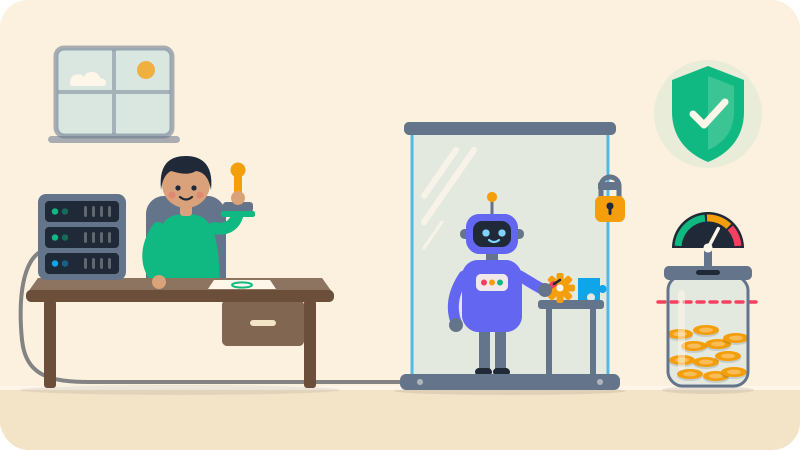
這條流水線可以直接接到這個系列在做的 AI 集群。角色拆開,從重現、找根因到修補和驗證,每個 agent 只做一件事:
在拋棄式容器裡把 crash 重跑出來;跑不出來就停,不往下走
用除錯器追到第一個出錯的地方,寫清楚是哪個假設錯了
三個不同的模型各寫一份,彼此看不到對方
不寫也不改程式,只負責執行:編譯、PoC、fuzz、測試、輸出比對
照清單找刪功能、改測試、檢查過寬這類錯法;意見只是參考,不能取代執行
每一行都看懂才送出,審查者的問題自己回
修補者用三個不同的模型,是因為 AIxCC 冠軍 Team Atlanta 的研究發現,選哪個模型比選哪個 agent 框架影響更大,而三個一組最划算。
沙箱的規則:
- 每個 bug 開一個新的拋棄式容器(用完就丟的隔離環境),做完整個丟掉。
- 容器裡不放任何金鑰。模型呼叫都走外面的 LiteLLM 代理,金鑰留在代理那邊,也在那裡替每個 agent 設美元上限。OSS-CRS 也是用 LiteLLM 來管預算。
- 網路只開白名單:只能連到代理和下載原始碼的地方,其他一律擋掉。
- 測試檔和 bug 留言一律當成不可信的資料。裡面可能藏著寫給 AI 的指令,想騙它做別的事,這叫 prompt injection(提示注入)。agent 讀到這種文字只能回報,不能照做。
大廠也是這樣做。Chrome 資安團隊把掃描放在鎖住、限制網路的機器上跑;Mozilla 的工作跑在用完即丟的虛擬機裡。
人類檢查點有兩個:要修哪些 bug 由我挑;任何要離開沙箱的動作,例如上傳、送報告、寄信,都先停下來等我。
這就是 Day 1 安全先行計畫的具體版本:先限制 agent 能碰什麼,再讓它多做事。驗證者、審查者和修補者分開,則是 Day 3 的教訓:AI 說做完了,獨立審查還是找出 37 個問題。做事的人,不能自己說做完了。
先知道的現實與紅線
- 很可能跟 Google 撞車。前面說過,Chrome 內部每天都在用 AI 掃描和修補,據報導獎金也已經把內部 AI 找得到的算進去。外人的價值在內部工具漏掉的地方,不然就當成練習。
- 沒驗證過的 AI 報告會傷信用。照 Chromium 給分流人員的 Shepherding AI Reports 文件,沒有可用 PoC 或合理 ASan 堆疊的 AI 報告,可以直接關成 WontFix;Google 也從 2026-10-01 起暫停 OSS VRP 收新的產品漏洞報告,原因是湧進大量大多無效的自動化和 AI 報告(BleepingComputer,2026-10-05)。
- 沒修好的 bug 不公開細節。等修好、通常再過 30 天公開之後才寫;受限的 bug 不要想辦法看。
- 尊重小專案。libxml2 在 2025 年中停止提供安全保密期(修好前先不公開的約定),長期維護者也在 2025 年 9 月卸任。維護者對直接丟過來的 AI PR 反應很差,比較好的做法是先開 issue 或私下回報,再說可以提供修補(OpenSSF podcast,2026 年 2 月)。在本機練舊 bug 沒問題,但不要把一堆 AI 修補丟給人手不夠的專案。
- 受限 bug 的細節不要貼進第三方 AI 服務,除非專案明說可以。我沒找到明文規定,所以先問。
- 這篇是防守研究。只談重現、找根因、修補、驗證、負責任地公開。PoC 在這裡就是「讓 crash 再發生一次的檔案」,不談怎麼利用漏洞。
結語
AI 寫修補草稿已經不難,難的是證明它是對的。一個人能做的,是讓每一步都由程式來驗證,最後一關留給自己。我會從第 0 步開始:先挑 20 個 ARVO 的舊 bug,把四個數字量出來,有結果再寫成日誌。
參考資料
業界系統
- Chrome 資安團隊:Chrome stronger with every update,2026-07-30
- Google DeepMind:Introducing CodeMender,2025-10-06
- Google Cloud:CodeMender 預覽版,2026-07-22
- Google:OSS-Fuzz 報告附上 CodeMender 修補,2026-07-29
- Google Research:AI-powered patching,2024-01
- Chrome Releases:Big Sleep 找到的 CVE-2025-9478,2025-08-26
- DARPA:AIxCC 決賽結果,2025-08-08
- SoK:整理 AIxCC 各隊系統的論文,2026-02
- Trail of Bits:Buttercup,2026-10-09 查閱
- OpenSSF:OSS-CRS,2026-10-09 查閱;OSS-CRS 論文,2026-03
- OpenAI:Aardvark,現名 Codex Security,2025-10-30
- Anthropic:Claude Code Security,2026-02-20
- Mozilla Hacks:Firefox 強化的幕後,2026-05-07
修補對不對的研究
- PatchBench,2026-09-03
- CodeRover-S,ICSE-SEIP 2026,2026
- Meta:AutoPatchBench,2025-04-29
- Team Atlanta:修補集成研究,2026-03-11
- Northwestern 的修補研究,2026-10-07
- PatchAgent,USENIX Security 2025,2025
- VulDebugger,2025-04
- CyberGym-E2E,ICML 2026,2026-06
- ARVO 資料集,IEEE EuroS&P 2026,2026
Chromium 官方文件
- Linux 建置說明,2026-10-09 查閱
- ASan 文件,2026-10-09 查閱
- agents/skills 目錄,2026-10-09 查閱
- AI 程式碼政策,2026-10-09 查閱
- Security for agents,2026-10-09 查閱
- AI 產生的安全 bug FAQ,2026-04
- Shepherding AI Reports:分流 AI 回報的指引,2026-10-09 查閱
- 貢獻指南,2026-10-09 查閱
新聞與社群
- BleepingComputer:Google 暫停開源漏洞獎金計畫,2026-10-05
- OpenSSF:What's in the SOSS podcast,AIxCC 之後,2026-02